REEID EDITORIAL
다국어 워드프레스가 번역 작업이 아니라 엔지니어링 문제인 이유
다국어 워드프레스 웹사이트는 단순히 기존 웹사이트의 가시적 텍스트를 다른 언어로 교체한 것에 그치지 않습니다.
핵심 요약
방문자가 페이지에서 보는 것은 시스템의 일부에 불과합니다. 그 뒤에는 블록, 빌더 데이터, 맞춤 필드, 메타데이터, URL, 택소노미, 언어 관계, SEO 신호, 캐시된 출력 및 플러그인과 테마가 생성한 콘텐츠 의존성이 존재합니다.
방문자가 페이지에서 보는 것은 시스템의 일부에 불과합니다. 그 뒤에는 블록, 빌더 데이터, 맞춤 필드, 메타데이터, URL, 택소노미, 언어 관계, SEO 신호, 캐시된 출력 및 플러그인과 테마가 생성한 콘텐츠 의존성이 존재합니다.
번역은 그 시스템 내부의 하나의 작업일 뿐입니다.
진정한 도전은 모든 관련 콘텐츠를 발견하고, 그 구조를 유지하며, 각 언어 버전을 올바르게 연결하고, 웹사이트가 변경된 후에도 모든 것을 유지관리 가능하게 만드는 것입니다.
따라서 신뢰할 수 있는 다국어 워드프레스는 단순한 번역이 아닌 엔지니어링이 필요합니다.
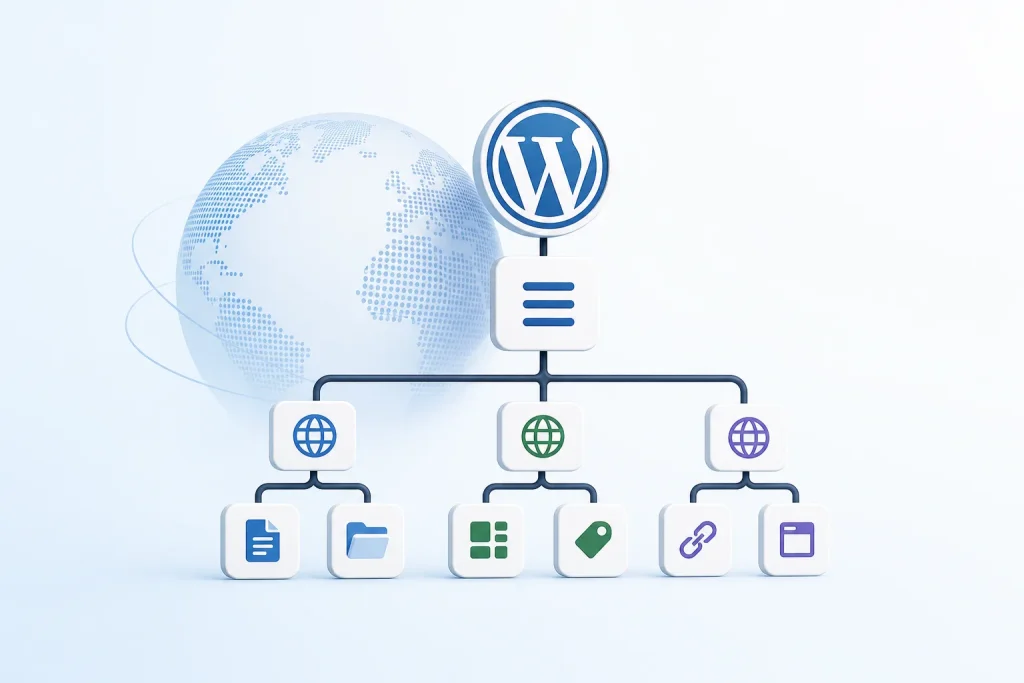
워드프레스 페이지는 가시적 텍스트 그 이상입니다
단순한 페이지는 제목, 여러 문단, 이미지, 버튼 정도로 보일 수 있습니다.
하지만 내부적으로는 같은 페이지에 다음과 같은 요소들이 포함되어 있을 수 있습니다:
- 구텐베르크 블록 속성
- 페이지 빌더 구성
- 버튼의 URL과 레이블
- 이미지 캡션과 대체 텍스트
- SEO 제목과 설명
- 맞춤 필드
- 재사용 가능한 패턴
- 택소노미 관계
- 쇼트코드
- 플러그인이 생성한 데이터
- 메인 포스트 본문 외부에 저장된 구조화된 콘텐츠
이 중 일부 정보는 방문자에게 노출되며, 일부는 검색엔진에 영향을 미치고, 일부는 페이지 레이아웃을 제어하며, 또 일부는 특정 조건에서만 나타날 수 있습니다.
따라서 ‘번역 시스템’은 모든 번역 가능한 콘텐츠가 워드프레스의 한 개의 편집창에 존재한다고 안전하게 가정할 수 없습니다. 콘텐츠가 어디에 저장되어 있고, 어떤 부분을 번역해야 하며, 어떤 부분은 변하지 않아야 하는지를 파악해야 합니다. 1. 번역에 앞서 콘텐츠 발굴이 우선입니다
무엇이든 번역하기 전에 시스템은 더 어려운 질문에 답해야 합니다:
도대체 무엇이 이 페이지에 속하는가?
가시적인 포스트 콘텐츠는 분명한 출발점이지만, 거의 항상 완전한 답은 아닙니다.
페이지는 다음 요소들에 의존할 수 있습니다:
포스트 제목과 추천문
구텐베르크 블록들
- 맞춤 포스트 메타
- 어드밴스드 커스텀 필드
- 테마 설정
- 위젯 콘텐츠
- 네비게이션 레이블
- 폼들
- 제품 속성
- SEO 플러그인 필드
- 재사용 가능한 템플릿
- 글로벌 블록들
- 플러그인별 데이터베이스 테이블
- 이들 중 하나라도 누락되면 언어 버전이 불완전해질 수 있습니다.
- 잘못된 데이터를 번역하는 것도 똑같이 피해를 줄 수 있습니다. 내부 식별자, CSS 클래스, URL, 구성값, 직렬화된 구조물 등은 기술적 목적을 수행하면서도 텍스트처럼 보일 수 있습니다.
따라서 신뢰할 수 있는 콘텐츠 발굴을 위해서는 다음과 같은 구분 규칙이 필요합니다:
인간이 읽을 수 있는 콘텐츠
구조적 데이터
- 내부 구성
- 다른 워드프레스 객체에 대한 참조
- 특별한 처리가 필요한 값들
- 최종 번역의 품질은 이 발굴 단계에 크게 좌우됩니다. 완벽한 번역 모델이라도 결코 받지 못한 콘텐츠는 번역할 수 없습니다.
- 2. 빌더 구조는 과정에서도 유지되어야 합니다
현대 워드프레스 페이지는 구조화된 문서입니다.
구텐베르크는 콘텐츠를 블록의 계층 구조로 저장합니다. 페이지 빌더들은 종종 레이아웃을 섹션, 열, 위젯, 스타일 설정, 재사용 가능한 요소에 대한 참조 등을 포함한 중첩된 데이터로 저장합니다.
텍스트는 그 구조를 이해하지 않고는 항상 추출·번역·재삽입이 가능하지 않습니다.
예를 들어 버튼 블록을 생각해 보겠습니다. 여기에는 다음과 같은 요소들이 포함될 수 있습니다:
가시적 버튼 텍스트
목적지 URL
- CSS 클래스
- 정렬 설정
- 링크 동작
- 추적 속성
- 디자인 설정
- 이 중 일부 데이터만 일반적으로 번역되어야 합니다.
- 제목, 아코디언, 탭, 추천 글, 가격표, 제품 그리드, 재사용 가능한 템플릿 등에도 동일한 원칙이 적용됩니다.
다국어 워크플로우는 의도된 콘텐츠만 변경하면서도 구조를 반드시 보존해야 합니다.
그렇지 않으면 번역으로 인해 다음과 같은 문제가 발생할 수 있습니다:
깨진 블록 마크업
누락된 빌더 요소
- 손실된 스타일링
- 잘못된 링크
- 유효하지 않은 직렬화된 데이터
- 잘못된 컴포넌트에 표시되는 콘텐츠
- 더 이상 정상적으로 편집할 수 없는 페이지
- Content appearing in the wrong component
- Pages that can no longer be edited normally
이것은 언어학적 문제가 아닙니다. 데이터 변환 문제입니다.
3. 메타데이터와 사용자 정의 필드는 페이지의 일부입니다
중요한 웹사이트 콘텐츠는 종종 메인 편집기 외부에 존재합니다.
사용자 정의 필드에는 다음이 포함될 수 있습니다:
- 자막
- 행동 유도 라벨
- 제품 사양
- 장소 이름
- 다운로드 가능한 파일 설명
- 자주 묻는 질문
- 구조화된 콘텐츠 섹션
SEO 플러그인은 또한 제목, 설명, 소셜 미디어 텍스트 및 인덱싱 지침을 눈에 보이는 페이지 콘텐츠와 별도로 저장합니다.
이러한 필드를 무시하면, 번역된 페이지는 완전해 보일 수 있지만 사용자, 소셜 네트워크 또는 검색 엔진에는 여전히 미완성 상태로 남을 수 있습니다.
그러나 사용자 정의 필드를 모두 동일하게 취급할 수는 없습니다.
한 필드에는 번역 가능한 텍스트가 들어 있을 수 있습니다. 다른 필드에는 숫자 값, 객체 ID, URL 또는 기술 설정이 들어 있을 수 있습니다. 세 번째 필드는 자체 번역본이 필요한 다른 콘텐츠를 참조할 수 있습니다.
강력한 시스템에는 분야별 동작이 필요합니다:
- 번역
- 변경되지 않은 내용 복사
- 번역된 객체로 매핑
- 제외
- 사용자 지정 규칙을 사용한 처리
이는 맞춤형 테마, WooCommerce 확장 기능, 멤버십 시스템, 디렉터리 또는 기타 구조화된 콘텐츠가 있는 웹사이트에서 특히 중요합니다.
4. 모든 언어 버전에는 URL 아키텍처가 필요합니다
다국어 웹사이트는 번역된 페이지만으로는 부족합니다. 이를 찾고 식별할 수 있는 예측 가능한 방법이 필요합니다.
일반적인 구조에는 다음이 포함됩니다:
example.com/fr/page/fr.example.com/page/example.fr/page/
선택된 구조는 다음에 걸쳐 일관되게 적용되어야 합니다:
- 페이지
- 게시물
- 제품
- 카테고리
- 태그
- 아카이브
- 페이지네이션
- 검색 결과
- 사이트맵
- 정규 URL
번역된 슬러그는 또 다른 층을 추가합니다.
해야 할까요 /services/ 되다 /fr/services/ 또는 /fr/services-professionnels/?
소스 슬러그가 변경되면 어떻게 됩니까?
리다이렉트는 어떻게 처리해야 하나요?
두 개의 번역된 제목이 동일한 슬러그를 생성하면 어떻게 됩니까?
이러한 결정은 사용자, 내부 링크, 분석, 검색 엔진 및 향후 웹사이트 유지보수에 영향을 미칩니다.
따라서 URL 아키텍처는 다국어 시스템의 근본적인 구성 요소일 뿐이며, 번역 후에 적용되는 단순한 꾸미기 설정이 아닙니다.
5. 언어 버전은 서로 연결된 상태로 유지되어야 합니다
번역된 페이지는 단순히 다른 텍스트를 담고 있는 복제된 페이지가 아닙니다.
시스템은 다음을 알아야 합니다:
- 영어로 된 A 페이지
- 독일어로 된 페이지 B
- 태국어로 된 C 페이지
같은 기본 콘텐츠의 언어 버전입니다.
이러한 관계는 다음을 지원합니다:
- Language switchers
- Alternate-language metadata
- Correct internal links
- Content synchronization
- Administrative navigation
- Translation status
- Update detection
- Search-engine language signals
The relationship must also survive normal WordPress operations.
Pages may be duplicated, deleted, restored, moved to draft, scheduled or replaced. Products may have variations. Taxonomy terms may be renamed. Content may be imported or updated through an API.
If language relationships are weak or stored inconsistently, the multilingual structure gradually deteriorates.
Visitors may be sent to the wrong page. Search engines may receive conflicting signals. Editors may unknowingly update one version while leaving the others disconnected.
Language relationships are therefore part of the website’s data model.
6. Multilingual SEO requires coordinated signals
Publishing translated text does not automatically create a correctly optimized multilingual website.
Each language version may require its own:
- SEO 제목
- 메타 설명
- 슬러그
- 정규 URL
- 오픈 그래프 텍스트
- 구조화된 데이터
- 내부 링크
- 사이트맵 항목
검색 엔진은 또한 각 언어 버전들이 서로 어떻게 연관되어 있는지 이해해야 합니다.
이는 일반적으로 [[PHO:1]]과 같은 다른 언어의 참조를 포함합니다. hreflang, 하지만 이러한 참조는 기본 URL과 언어 간 관계가 정확할 때에만 제대로 작동합니다.
단 하나의 잘못된 URL이 연쇄적인 문제를 야기할 수 있습니다:
- 깨진 대체 언어 참조
- 충돌하는 정규 표현식
- 사이트맵에 누락된 페이지
- 검색 엔진이 잘못된 언어 버전을 선택하는 경우
- 서로 경쟁하는 지역 페이지들
- 인덱싱되지 않은 번역 페이지 남음
따라서 다국어 SEO는 번역, URL 생성, 메타데이터, 사이트맵 및 페이지 간 관계 간의 조정에 달려 있습니다.
프로젝트 마지막에 추가되는 체크박스처럼 취급해서는 안 됩니다.
7. 캐싱은 번역 시스템의 동작 방식을 변화시킵니다.
번역에는 비용이 많이 드는 작업들이 포함될 수 있습니다:
- 콘텐츠 읽기와 파싱
- 문자열 탐지
- AI 모델 또는 번역 제공업체 호출
- 구조화된 콘텐츠 재구성
- 번역된 기록 작성
- SEO 메타데이터 재생성
각 요청마다 모든 작업을 반복하면 속도가 느려지고 자원이 낭비됩니다.
캐싱은 처리 시간과 번역 비용을 절감할 수 있지만, 자체적인 기술적 문제를 야기합니다:
- 무엇을 캐싱해야 할까요?
- 원본 문자열은 어떻게 식별되나요?
- 캐시된 번역은 언제 만료되나요?
- 원본 텍스트가 변경되면 어떻게 되나요?
- 번역을 여러 페이지에서 재사용할 수 있을까요?
- 동일한 문자열이 하나의 번역을 공유해야 할까요?
- 수동 수정 사항은 어떻게 보존되나요?
- 오래된 콘텐츠는 어떻게 무효화되나요?
번역 캐시는 단순히 텍스트를 저장하는 것 이상의 역할을 해야 합니다.
다음 요소들을 고려해야 할 수 있습니다:
- 원어
- 목표어
- 번역 제공업체
- 모델
- 컨텍스트
- 용어
- 사이트
- 콘텐츠 유형
- 버전
- 수동 편집
부실한 캐시 설계는 오래된 또는 맥락적으로 부적절한 번역을 반환할 수 있습니다. 아예 캐싱을 하지 않으면 불필요한 비용과 처리 지연이 발생할 수 있습니다.
올바른 균형은 웹사이트의 구축 방식과 콘텐츠 변경 빈도에 따라 결정됩니다.
8. 동기화는 지속적인 과정입니다.
첫 번째 번역은 시작에 불과합니다.
런칭 이후에도 원본 웹사이트는 계속 변화합니다:
- 헤드라인이 다시 작성됩니다
- 제품 가격표가 업데이트됩니다
- 섹션이 삭제됩니다
- 버튼의 URL이 변경됩니다
- 이미지가 교체됩니다
- 맞춤 필드가 추가됩니다
- SEO 메타데이터가 수정됩니다
- 빌더 템플릿이 재설계됩니다
이후 다국어 시스템은 다음을 판단해야 합니다:
- 무엇이 변경되었나요?
- 어느 언어 버전이 영향을 받았나요?
- 어떤 콘텐츠를 다시 번역해야 하나요?
- 수동으로 편집한 번역은 어떤 것을 보존해야 하나요?
- 구조적 변경 사항은 자동으로 복제되어야 하나요?
- 오래된 번역 콘텐츠는 제거되어야 하나요?
- 업데이트에 인력 검토가 필요한가요?
단순히 전체 페이지를 다시 번역하는 것은 거의 최선의 해결책이 아닙니다.
이는 자원을 낭비하고 승인된 번역을 덮어씌울 수 있습니다. 변경 사항을 무시하면 구식 언어 버전이 생깁니다.
신뢰할 수 있는 동기화를 위해서는 변경 감지, 상태 추적, 그리고 원본 업데이트와 번역 콘텐츠 간 충돌 해결을 위한 명확한 규칙이 필요합니다.
9. 유지보수는 시스템이 여전히 신뢰할 수 있는지를 결정합니다.
다국어 웹사이트는 WordPress가 발전함에 따라 계속 작동해야 합니다.
테마와 플러그인들이 업데이트되고, 빌더들은 데이터 구조를 변경하며, 새로운 콘텐츠 유형이 도입되고, SEO 플러그인들은 필드를 추가합니다. WordPress는 블록 동작을 변경하고, 번역 제공업체들은 API와 모델을 업데이트합니다.
다국어 계층은 기존 콘텐츠를 손상시키지 않으면서 적응해야 합니다.
지속적인 유지보수에는 다음과 같은 항목들이 포함됩니다:
- 호환성 테스트
- 데이터베이스 마이그레이션
- 오류 처리
- 중단된 작업 후 복구
- 큐 관리
- 로그 기록
- 모니터링
- 접근 제어
- API 한도 처리
- 생성된 콘텐츠 검증
대규모 웹사이트는 또한 통제된 처리가 필요합니다.
단일 브라우저 요청으로 수천 개의 게시물을 번역하는 것은 현실적이지 않습니다. 작업은 큐와 배치로 나누어져야 하며, 재시도, 재개 가능한 작업, 부분 실패에 대한 지원이 필요합니다.
시스템은 실질적인 질문들에 답할 수 있어야 합니다:
- 어떤 페이지가 처리되었나요?
- 어떤 항목이 실패했나요?
- 왜 실패했나요?
- 어떤 번역이 구식인가요?
- 어느 언어 버전이 누락되었나요?
- 처리를 안전하게 재개할 수 있나요?
이러한 운영 계층이 없으면 다국어 자동화는 신뢰하기 어려워집니다.
번역 품질은 여전히 중요하지만, 그것만으로는 충분하지 않습니다.
이 모든 것이 언어적 품질을 중요하지 않게 만드는 것은 아닙니다.
번역된 언어는 여전히 정확하고 자연스럽고 청중에게 적합해야 합니다. 용어, 어조, 맥락, 그리고 검토는 여전히 필수적입니다.
언어적 품질만으로는 기능적인 다국어 WordPress 웹사이트를 만들 수 없다는 점이 차이입니다.
잘 작성된 번역이라도 잘못된 분야에 배치될 수 있습니다.
레이아웃이 깨진 페이지에도 존재할 수 있습니다.
소스와 연결이 끊어질 수 있습니다.
올바르지 않은 표준 URL을 사용할 수 있습니다.
빌더 템플릿이 업데이트될 때 사라질 수 있습니다.
검색엔진에게 보이지 않을 수 있습니다.
성공적인 다국어 출판을 위해서는 언어의 품질과 기술적 완전성이 모두 필요합니다.
AI의 역할
AI는 고품질 번역을 더 빠르고 접근하기 쉽게 만들어 주었습니다.
다음과 같은 작업을 지원할 수 있습니다:
- 번역
- 재작성
- 용어 관리
- 맥락 적응
- 메타데이터 생성
- 요약
- 품질 검토
하지만 AI는 다국어 아키텍처의 필요성을 없애지는 못합니다.
모델은 여전히 올바른 콘텐츠를 받아야 합니다. 출력물은 반드시 올바른 위치로 반환되어야 하며, 워드프레스 구조는 유효해야 하고, URL과 언어 간 관계가 설정되어야 합니다. 업데이트가 감지되고, 승인된 콘텐츠는 반드시 보호되어야 합니다.
AI 모델에 단락 하나를 보내는 것은 쉽습니다.
그러나 그 모델을 중심으로 신뢰할 수 있는 다국어 워드프레스 시스템을 운영하는 것이 어려운 부분입니다.
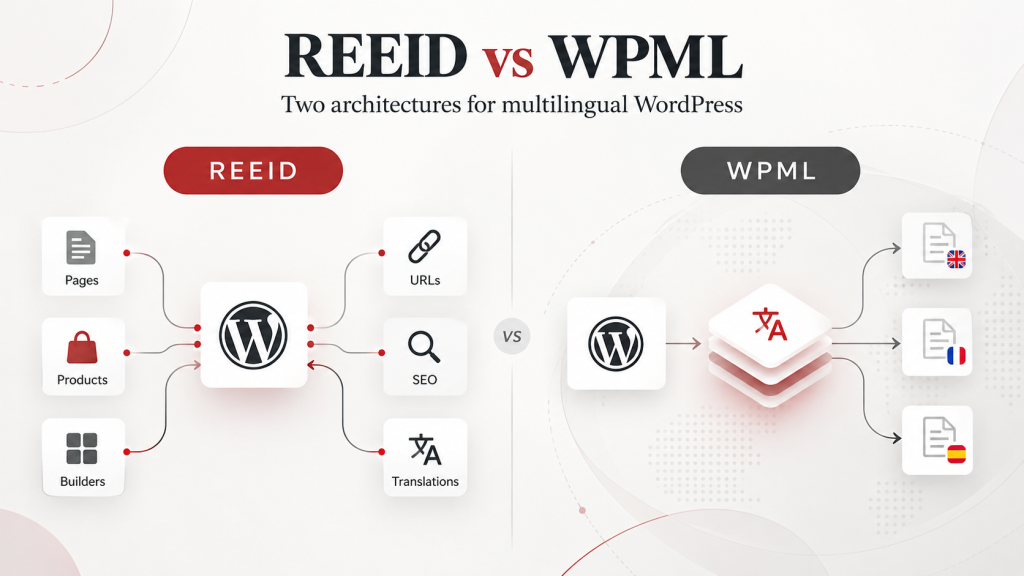
REEID가 다국어 워드프레스를 접근하는 방식
REEID는 다국어 워드프레스를 기술적인 콘텐츠 처리 시스템으로 접근합니다.
작업은 단순히 텍스트를 교체하는 것 이상으로, 워드프레스가 콘텐츠를 저장하는 방식, 빌더가 페이지를 구성하는 방식, 플러그인이 추가 필드를 어떻게 도입하는지, 그리고 언어 버전들이 시간이 지나도 어떻게 연결되어 있어야 하는지를 이해하는 것을 포함합니다.
이러한 접근법은 다음과 같은 요소들을 한데 모읍니다:
- 콘텐츠 탐색
- 구조화된 추출
- 워드프레스 네이티브 처리
- AI 지원 번역
- 메타데이터 처리
- 언어 간 관계
- 다국어 SEO
- 번역 재사용
- 동기화
- 호환성 작업
- 지속적인 유지보수
목표는 단순히 번역된 텍스트를 만드는 것이 아닙니다.
오히려 편집 가능하고, 연결되어 있으며, 발견 가능하고, 유지보수가 가능한 다국어 워드프레스 콘텐츠를 생산하는 것입니다.
결론
다국어 워드프레스 웹사이트는 서로 연관된 콘텐츠, 구조, URL 및 기술적 신호들의 네트워크입니다.
번역은 그 네트워크에서 중요한 부분이지만, 단지 하나의 부분일 뿐입니다.
전체 문제에는 콘텐츠를 발견하고, 빌더 구조를 보존하며, 메타데이터를 처리하고, URL을 관리하고, 언어 버전들을 연결하며, SEO를 지원하고, 결과를 캐시하며, 변화를 동기화하고, 시간이 지나도 호환성을 유지하는 일이 포함됩니다.
다국어 워드프레스를 번역 작업으로만 취급하면 작은 정적인 페이지에서는 통할 수 있습니다.
공학적 시스템으로 접근해야만 대규모에서도 안정적으로 작동할 수 있습니다.
출처 및 증거