REEID EDITORIAL
मल्टीलिंगुअल WordPress एक इंजीनियरिंग समस्या है, न कि एक अनुवाद कार्य
एक मल्टीलिंगुअल WordPress वेबसाइट केवल एक मौजूदा वेबसाइट नहीं है जिसका दृश्य पाठ दूसरी भाषा में बदल दिया गया हो।
मुख्य बात
आपके दर्शकों को पृष्ठ पर जो दिखता है, वह केवल सिस्टम का एक हिस्सा है। इसके पीछे ब्लॉक्स, बिल्डर डेटा, कस्टम फ़ील्ड, मेटाडेटा, URL, टैक्सोनॉमी, भाषा संबंध, SEO सिग्नल, कैश्ड आउटपुट और प्लगइन्स तथा थीम्स द्वारा बनाए गए सामग्री निर्भरताएं होती हैं।
आपके दर्शकों को पृष्ठ पर जो दिखता है, वह केवल सिस्टम का एक हिस्सा है। इसके पीछे ब्लॉक्स, बिल्डर डेटा, कस्टम फ़ील्ड, मेटाडेटा, URL, टैक्सोनॉमी, भाषा संबंध, SEO सिग्नल, कैश्ड आउटपुट और प्लगइन्स तथा थीम्स द्वारा बनाए गए सामग्री निर्भरताएं होती हैं।
अनुवाद उस सिस्टम के अंदर का एक कार्य है।
वास्तविक चुनौती यह है कि सभी प्रासंगिक सामग्री की खोज करना, उनकी संरचना को बरकरार रखना, प्रत्येक भाषा संस्करण को सही तरीके से जोड़ना और वेबसाइट में बदलाव के बाद सब कुछ रखरखाव योग्य बनाए रखना।
इसीलिए विश्वसनीय मल्टीलिंगुअल WordPress को इंजीनियरिंग की आवश्यकता होती है—न केवल अनुवाद की।
एक WordPress पृष्ठ दृश्य पाठ से कहीं अधिक है
एक साधारण पृष्ठ में एक शीर्षक, कई पैराग्राफ, एक छवि और एक बटन दिखाई दे सकते हैं।
हालाँकि, आंतरिक रूप से वही पृष्ठ इन चीज़ों को भी शामिल कर सकता है:
- गुटेनबर्ग ब्लॉक एट्रिब्यूट्स
- पेज-बिल्डर कॉन्फ़िगरेशन
- बटन के URL और लेबल्स
- छवि कैप्शन और वैकल्पिक पाठ
- SEO शीर्षक और विवरण
- कस्टम फ़ील्ड्स
- पुनर्बार उपयोगी पैटर्न्स
- टैक्सोनॉमी संबंध
- शॉर्टकोड्स
- प्लगइन द्वारा उत्पन्न डेटा
- मुख्य पोस्ट बॉडी के बाहर संग्रहीत संरचित सामग्री
इनमें से कुछ जानकारी दर्शकों को दिखाई देती है। कुछ खोज इंजनों को प्रभावित करती है। कुछ पृष्ठ के लेआउट को नियंत्रित करती है। कुछ केवल विशेष परिस्थितियों में ही दिखाई दे सकती है।
एक “अनुवाद प्रणाली” इसलिए सुरक्षित रूप से यह मान नहीं सकती कि सभी अनुवाद योग्य सामग्री एक ही WordPress एडिटर फ़ील्ड में मौजूद है। उसे यह समझना होगा कि सामग्री कहाँ संग्रहीत है, किन हिस्सों का अनुवाद किया जाना चाहिए और किन हिस्सों को अपरिवर्तित रखना है। 1. अनुवाद से पहले सामग्री की खोज होती है
कुछ भी अनुवाद करने से पहले, सिस्टम को एक और कठिन सवाल का जवाब देना होगा:
वास्तव में यह पृष्ठ किसका है?
दृश्य पोस्ट सामग्री एक स्पष्ट शुरुआती बिंदु है, लेकिन यह शायद ही पूरा जवाब होता है।
एक पृष्ठ इन चीज़ों पर निर्भर हो सकता है:
पोस्ट शीर्षक और अंश
गुटेनबर्ग ब्लॉक्स
- कस्टम पोस्ट मेटा
- एडवांस्ड कस्टम फ़ील्ड्स
- थीम सेटिंग्स
- विजेट कंटेंट
- नेविगेशन लेबल्स
- फ़ॉर्म्स
- प्रोडक्ट एट्रिब्यूट्स
- SEO प्लगइन फ़ील्ड्स
- पुनर्बार उपयोगी टेम्प्लेट्स
- ग्लोबल ब्लॉक्स
- प्लगइन-विशिष्ट डेटाबेस टेबल्स
- इनमें से किसी का भी अभाव एक अधूरे भाषा संस्करण का कारण बन सकता है।
- गलत डेटा का अनुवाद भी उतना ही हानिकारक हो सकता है। आंतरिक पहचानकर्ता, CSS क्लासेस, URL, कॉन्फ़िगरेशन मूल्य और सीरियलाइज़्ड संरचनाएं भी पाठ की तरह दिख सकती हैं, जबकि वे तकनीकी उद्देश्यों के लिए कार्य करती हैं।
इसलिए विश्वसनीय सामग्री की खोज के लिए इन चीज़ों को अलग करने के नियमों की आवश्यकता होती है:
मानव-पढ़ने योग्य सामग्री
संरचनात्मक डेटा
- आंतरिक कॉन्फ़िगरेशन
- अन्य WordPress ऑब्जेक्ट्स के संदर्भ
- विशेष प्रक्रिया की आवश्यकता वाले मूल्य
- अंतिम अनुवाद की गुणवत्ता इस खोज चरण पर बहुत निर्भर करती है। एक सटीक अनुवाद मॉडल उस सामग्री का अनुवाद नहीं कर सकता जो उसे कभी नहीं मिलती।
- 2. बिल्डर संरचनाओं को प्रक्रिया में बचाना होता है
आधुनिक WordPress पृष्ठ एक संरचित दस्तावेज़ है।
गुटेनबर्ग सामग्री को ब्लॉक्स की एक श्रेणीबद्ध संरचना के रूप में संग्रहीत करता है। पेज बिल्डर अक्सर लेआउट्स को नेस्टेड डेटा के रूप में संग्रहीत करते हैं, जिसमें सेक्शन, कॉलम, विजेट्स, स्टाइल सेटिंग्स और पुनर्बार उपयोगी तत्वों के संदर्भ शामिल होते हैं।
पाठ को हमेशा उस संरचना को समझे बिना निकाला, अनुवाद किया और वापस डाला नहीं जा सकता।
एक बटन ब्लॉक को ले लें। इसमें शामिल हो सकते हैं:
दृश्य बटन पाठ
गंतव्य URL
- CSS क्लासेस
- संरेखण सेटिंग्स
- लिंक व्यवहार
- ट्रैकिंग एट्रिब्यूट्स
- डिज़ाइन सेटिंग्स
- इनमें से केवल एक हिस्सा ही सामान्य रूप से अनुवाद किया जाना चाहिए।
- यही बात हेडिंग्स, एकॉर्डियन्स, टैब्स, टेस्टिमोनियल्स, प्राइसिंग टेबल्स, प्रोडक्ट ग्रिड्स और पुनर्बार उपयोगी टेम्प्लेट्स के लिए भी लागू होती है।
एक मल्टीलिंगुअल वर्कफ़्लो को इरादे से बदली गई सामग्री को ही बदलते हुए, संरचना को बरकरार रखना चाहिए।
अन्यथा, अनुवाद से ये नुकसान हो सकते हैं:
टूटी हुई ब्लॉक मार्कअप
गायब हुए बिल्डर तत्व
- खोई हुई स्टाइलिंग
- गलत लिंक्स
- अमान्य सीरियलाइज़्ड डेटा
- गलत कंपोनेंट में दिखने वाली सामग्री
- ऐसे पृष्ठ जिन्हें अब सामान्य रूप से संपादित नहीं किया जा सकता
- Content appearing in the wrong component
- Pages that can no longer be edited normally
यह कोई भाषाविज्ञान संबंधी समस्या नहीं है। यह डेटा परिवर्तन संबंधी समस्या है।
3. मेटाडेटा और कस्टम फील्ड पृष्ठ का हिस्सा हैं
महत्वपूर्ण वेबसाइट सामग्री अक्सर मुख्य संपादक से बाहर मौजूद होती है।
एक कस्टम फील्ड में निम्नलिखित हो सकते हैं:
- एक उपशीर्षक
- एक कॉल-टू-एक्शन लेबल
- एक उत्पाद विनिर्देश
- एक स्थान का नाम
- एक डाउनलोड करने योग्य फ़ाइल का विवरण
- एक अक्सर पूछे जाने वाले प्रश्न
- एक संरचित सामग्री खंड
SEO प्लगइन्स शीर्षक, विवरण, सोशल मीडिया टेक्स्ट और इंडेक्सिंग निर्देशों को भी दृश्य पृष्ठ सामग्री से अलग रखते हैं।
अगर इन फील्ड्स को नजरअंदाज किया जाता है, तो अनुवादित पृष्ठ पूर्ण दिख सकता है, लेकिन उपयोगकर्ताओं, सोशल नेटवर्क या खोज इंजनों के लिए अपूर्ण रह सकता है।
हालाँकि, सभी कस्टम फील्ड्स को एक जैसा व्यवहार नहीं दिया जा सकता।
एक फील्ड में अनुवाद योग्य पाठ हो सकता है। दूसरे में संख्यात्मक मान, ऑब्जेक्ट ID, URL या तकनीकी सेटिंग हो सकती है। तीसरा एक अन्य सामग्री का संदर्भ दे सकता है जिसे अपने अनुवादित समकक्ष की आवश्यकता होती है।
एक मजबूत प्रणाली के लिए फील्ड-विशिष्ट व्यवहार की आवश्यकता होती है:
- अनुवाद करें
- अपरिवर्तित कॉपी करें
- अनुवादित ऑब्जेक्ट से मैप करें
- उपेक्षा करें
- कस्टम नियम का उपयोग करके प्रोसेस करें
यह विशेष रूप से कस्टम थीम, WooCommerce एक्सटेंशन, सदस्यता प्रणाली, डायरेक्टरी या अन्य संरचित सामग्री वाली वेबसाइटों पर महत्वपूर्ण है।
4. प्रत्येक भाषा संस्करण के लिए एक URL आर्किटेक्चर की आवश्यकता होती है
एक बहुभाषी वेबसाइट को अनुवादित पृष्ठों से अधिक की आवश्यकता होती है। उन्हें ढूँढने और पहचानने का एक अनुमानित तरीका चाहिए।
आम संरचनाएँ इस प्रकार हैं:
example.com/fr/page/fr.example.com/page/example.fr/page/
चाहे जो भी संरचना चुनी जाए, उसे निम्नलिखित में लगातार लागू करना चाहिए:
- पृष्ठों
- पोस्ट्स
- उत्पादों
- श्रेणियों
- टैग्स
- आर्काइव्स
- पेजेशन
- खोज परिणाम
- साइटमैप्स
- कैनोनिकल URLs
अनुवादित स्लग्स एक और स्तर जोड़ते हैं।
क्या होता है जब स्रोत स्लग बदलता है? क्या होता है जब स्रोत स्लग बदलता है? क्या होता है जब स्रोत स्लग बदलता है? क्या होता है जब स्रोत स्लग बदलता है? क्या होता है जब स्रोत स्लग बदलता है? क्या होता है जब स्रोत स्लग बदलता है?क्या होता है जब स्रोत स्लग बदलता है?
क्या होता है जब स्रोत स्लग बदलता है?
क्या होता है जब स्रोत स्लग बदलता है?
क्या होता है जब स्रोत स्लग बदलता है?
क्या होता है जब स्रोत स्लग बदलता है?
क्या होता है जब स्रोत स्लग बदलता है?
5. भाषा संस्करणों को आपस में जोड़े रखना चाहिए
एक अनुवादित पृष्ठ केवल अलग-अलग पाठ वाला एक डुप्लिकेट पृष्ठ नहीं है।
प्रणाली को यह जानना चाहिए कि:
- अंग्रेजी में पृष्ठ A
- जर्मन में पृष्ठ B
- थाई में पृष्ठ C
एक ही अंतर्निहित सामग्री के विभिन्न भाषा संस्करण हैं।
ये संबंध निम्नलिखित का समर्थन करते हैं:
- भाषा स्विचर्स
- वैकल्पिक भाषा मेटाडेटा
- सही आंतरिक लिंक्स
- सामग्री सिंक्रनाइज़ेशन
- प्रशासनिक नेविगेशन
- अनुवाद की स्थिति
- अपडेट डिटेक्शन
- खोज इंजन भाषा संकेत
यह संबंध WordPress के सामान्य संचालन के दौरान भी बना रहना चाहिए।
पृष्ठ डुप्लिकेट हो सकते हैं, हटाए जा सकते हैं, बहाल किए जा सकते हैं, ड्राफ्ट में ले जाए जा सकते हैं, शेड्यूल किए जा सकते हैं या बदले जा सकते हैं। उत्पादों में विविधता हो सकती है। टैक्सोनॉमी शब्दों का नाम बदला जा सकता है। सामग्री API के माध्यम से आयात या अपडेट की जा सकती है।
अगर भाषा संबंध कमजोर है या असंगत रूप से संग्रहीत है, तो बहुभाषी संरचना धीरे-धीरे बिगड़ने लगती है।
आगंतुकों को गलत पृष्ठ पर भेजा जा सकता है। खोज इंजनों को विरोधाभासी संकेत मिल सकते हैं। संपादक अनजाने में एक संस्करण को अपडेट कर सकते हैं, जबकि अन्य को अलग छोड़ देते हैं।
भाषा संबंध इसलिए वेबसाइट के डेटा मॉडल का हिस्सा है।
6. बहुभाषी SEO के लिए समन्वित संकेतों की आवश्यकता होती है
अनुवादित पाठ प्रकाशित करने से स्वचालित रूप से सही तरीके से अनुकूलित एक बहुभाषी वेबसाइट नहीं बनती। बहुभाषी वेबसाइट.
प्रत्येक भाषा संस्करण को अपने अनुकूलित शीर्षक, मेटा विवरण, स्लग, कैनोनिकल URL, ओपन ग्राफ टेक्स्ट, संरचित डेटा, आंतरिक लिंक्स, साइटमैप एंट्री और खोज इंजन भाषा संकेत की आवश्यकता होती है।
- यह आमतौर पर वैकल्पिक भाषा संदर्भ जैसे कि
- hreflang
- के साथ होता है, लेकिन ये संदर्भ केवल तभी सही तरीके से काम करते हैं जब अंतर्निहित URLs और भाषा संबंध सटीक होते हैं।
- एक गलत URL एक समस्या की श्रृंखला पैदा कर सकता है:
- टूटे हुए वैकल्पिक भाषा संदर्भ
- विरोधाभासी कैनोनिकल्स
- साइटमैप्स में गायब पृष्ठ
- खोज इंजनों को गलत भाषा संस्करण चुनने की आवश्यकता होती है।
यह संबंध भी वर्डप्रेस के सामान्य संचालन के दौरान बना रहना चाहिए।
यह आमतौर पर वैकल्पिक भाषा संदर्भ जैसे कि hreflangके साथ होता है, लेकिन ये संदर्भ केवल तभी सही तरीके से काम करते हैं जब अंतर्निहित URLs और भाषा संबंध सटीक होते हैं।
एक गलत URL एक समस्या की श्रृंखला पैदा कर सकता है:
- टूटे हुए वैकल्पिक भाषा संदर्भ
- विरोधाभासी कैनोनिकल्स
- साइटमैप्स में गायब पृष्ठ
- खोज इंजनों को गलत भाषा संस्करण चुनने की आवश्यकता होती है।
- क्षेत्रीय पृष्ठ एक-दूसरे के साथ प्रतिस्पर्धा करते हैं।
- अनुवादित पृष्ठ अनिंडेक्सेड रहते हैं।
बहुभाषी SEO इसलिए अनुवाद, URL जनरेशन, मेटाडेटा, साइटमैप्स और पृष्ठ संबंधों के बीच समन्वय पर निर्भर करता है।
इसे परियोजना के अंत में जोड़े गए एक चेकबॉक्स की तरह नहीं माना जा सकता।
7. कैशिंग अनुवाद प्रणालियों के व्यवहार को बदल देती है
अनुवाद में महंगे ऑपरेशन शामिल हो सकते हैं:
- सामग्री को पढ़ना और पार्स करना
- स्ट्रिंग्स की खोज करना
- AI मॉडल या अनुवाद प्रदाता को कॉल करना
- संरचित सामग्री को फिर से बनाना
- अनुवादित रिकॉर्ड लिखना
- SEO मेटाडेटा को फिर से जनरेट करना
हर अनुरोध पर हर ऑपरेशन को दोहराना धीमा और बेकार होगा।
कैशिंग प्रोसेसिंग समय और अनुवाद लागत को कम कर सकती है, लेकिन यह अपने इंजीनियरिंग संबंधी सवाल भी लाती है:
- किसे कैश किया जाना चाहिए?
- एक स्रोत स्ट्रिंग की पहचान कैसे की जाती है?
- कैश किए गए अनुवाद की समय-सीमा कब खत्म होती है?
- मूल पाठ में बदलाव होने पर क्या होता है?
- क्या पृष्ठों के बीच अनुवादों का पुनर्बार किया जा सकता है?
- क्या एक जैसी स्ट्रिंग्स को एक ही अनुवाद साझा करना चाहिए?
- मैनुअल सुधार कैसे संरक्षित किए जाते हैं?
- बासी सामग्री को कैसे अमान्य किया जाता है?
एक अनुवाद कैश बस टेक्स्ट स्टोर करने से अधिक काम करना चाहिए।
इसमें ये चीजों का ध्यान रखना पड़ सकता है:
- स्रोत भाषा
- लक्ष्य भाषा
- अनुवाद प्रदाता
- मॉडल
- संदर्भ
- शब्दावली
- साइट
- सामग्री का प्रकार
- संस्करण
- मैनुअल संपादन
खराब कैश डिजाइन अपडेटेड या संदर्भ से असंगत अनुवाद दे सकता है। बिल्कुल कैशिंग न करने से अनावश्यक लागत और प्रोसेसिंग विलंब हो सकता है।
सही संतुलन निर्भर करता है कि वेबसाइट कैसे बनाई गई है और इसकी सामग्री कितनी बार बदलती है।
8. सिंक्रनाइज़ेशन एक चलती प्रक्रिया है
पहला अनुवाद सिर्फ शुरुआत है।
लॉन्च के बाद, स्रोत वेबसाइट बदलती रहती है:
- एक हेडिंग को फिर से लिखा जाता है
- एक उत्पाद की कीमत की तालिका अपडेट की जाती है
- एक सेक्शन को हटाया जाता है
- एक बटन का URL बदल जाता है
- एक इमेज को बदल दिया जाता है
- एक कस्टम फील्ड जोड़ा जाता है
- SEO मेटाडेटा को संशोधित किया जाता है
- एक बिल्डर टेम्पलेट को फिर से डिजाइन किया जाता है
बहुभाषी प्रणाली को फिर से निर्धारित करना पड़ता है:
- क्या बदला गया है?
- कौन से भाषा संस्करण प्रभावित हुए हैं?
- कौन सी सामग्री को फिर से अनुवाद करना चाहिए?
- कौन से मैनुअल संपादित अनुवादों को संरक्षित करना चाहिए?
- क्या संरचनात्मक बदलावों को स्वचालित रूप से कॉपी करना चाहिए?
- क्या पुराने अनुवादित सामग्री को हटाना चाहिए?
- क्या अपडेट को मानवीय समीक्षा की आवश्यकता है?
पूरी पृष्ठ को फिर से अनुवाद करना शायद ही सर्वोत्तम समाधान होता है।
यह संसाधनों की बर्बादी और अनुमोदित अनुवादों को ओवरराइट कर सकता है। बदलावों को नजरअंदाज करने से पुराने भाषा संस्करण बनते हैं।
विश्वसनीय सिंक्रनाइज़ेशन के लिए बदलाव का पता लगाना, राज्य का ट्रैकिंग और स्रोत अपडेट तथा अनुवादित सामग्री के बीच संघर्षों को हल करने के स्पष्ट नियमों की आवश्यकता होती है।
9. रखरखाव तय करता है कि प्रणाली विश्वसनीय बनी रहती है या नहीं
एक बहुभाषी वेबसाइट को WordPress के विकास के साथ काम करते रहना चाहिए।
थीम और प्लगइन्स अपडेट होते हैं। बिल्डर्स अपनी डेटा संरचना बदलते हैं। नए सामग्री प्रकार पेश किए जाते हैं। SEO प्लगइन्स फील्ड जोड़ते हैं। WordPress ब्लॉक व्यवहार बदलता है। अनुवाद प्रदाता अपने API और मॉडल को अपडेट करते हैं।
बहुभाषी परत को मौजूदा सामग्री को नुकसान पहुंचाए बिना अनुकूलित करना चाहिए।
चलते रखरखाव में शामिल हैं:
- संगतता परीक्षण
- डेटाबेस माइग्रेशन
- एरर हैंडलिंग
- अर्धचालित कार्यों के बाद रिकवरी
- क्यू मैनेजमेंट
- लॉगिंग
- मॉनिटरिंग
- एक्सेस कंट्रोल
- API लिमिट हैंडलिंग
- जनरेटेड सामग्री का वैलिडेशन
बड़ी वेबसाइटों को नियंत्रित प्रोसेसिंग की भी आवश्यकता होती है।
एक ही ब्राउज़र अनुरोध में हजारों पोस्ट का अनुवाद करना वास्तविक नहीं है। काम को क्यू और बैच में विभाजित करना पड़ सकता है, रिट्राय, रेज़्यूमेबल जॉब्स और पार्शियल फेल्योर का समर्थन करना चाहिए।
प्रणाली को व्यावहारिक सवालों का जवाब देना चाहिए:
- कौन से पृष्ठों को प्रोसेस किया गया है?
- कौन से आइटम फेल हुए हैं?
- उन्हें फेल होने का कारण क्या है?
- कौन से अनुवाद पुराने हैं?
- कौन से भाषा संस्करण गायब हैं?
- क्या प्रोसेसिंग सुरक्षित रूप से फिर से शुरू की जा सकती है?
इस ऑपरेशनल परत के बिना, बहुभाषी ऑटोमेशन पर भरोसा करना मुश्किल हो जाता है।
अनुवाद की गुणवत्ता अभी भी मायने रखती है—लेकिन यह पर्याप्त नहीं है
इन सबसे यह नहीं है कि भाषाई गुणवत्ता अनमहत्वपूर्ण है।
अनुवादित भाषा को अभी भी सटीक, प्राकृतिक और अपने दर्शकों के लिए उपयुक्त होना चाहिए। शब्दावली, टोन, संदर्भ और समीक्षा अभी भी जरूरी हैं।
अंतर यह है कि भाषाई गुणवत्ता अकेले एक कार्यात्मक बहुभाषी WordPress वेबसाइट नहीं बना सकती।
एक अच्छी तरह से लिखित अनुवाद को भी गलत फील्ड में रखा जा सकता है।
यह एक ऐसे पृष्ठ पर मौजूद हो सकता है जिसका लेआउट खराब है।
इसे इसके स्रोत से डिस्कनेक्ट किया जा सकता है।
यह गलत कैनोनिकल URL का उपयोग कर सकता है।
एक बिल्डर टेम्पलेट के अपडेट होने पर यह गायब हो सकता है।
यह खोज इंजनों के लिए अदृश्य रह सकता है।
सफल बहुभाषी प्रकाशन के लिए भाषा की गुणवत्ता और तकनीकी अखंडता दोनों आवश्यक हैं।
AI की भूमिका
AI ने उच्च गुणवत्ता वाले अनुवाद को तेज़ और अधिक सुलभ बनाया है।
यह इनकी सहायता कर सकता है:
- अनुवाद
- री-राइटिंग
- शब्दावली
- संदर्भ का अनुकूलन
- मेटाडेटा जनरेशन
- संक्षेपण
- गुणवत्ता समीक्षा
लेकिन AI बहुभाषी आर्किटेक्चर की आवश्यकता को नहीं हटाता है।
मॉडल को अभी भी सही सामग्री प्राप्त करने की आवश्यकता है। इसके आउटपुट को सही स्थान पर वापस भेजना होगा। WordPress संरचनाएं वैध रहनी चाहिए। URLs और भाषा संबंधों का निर्माण करना होगा। अपडेट का पता लगाना होगा। अनुमोदित सामग्री की सुरक्षा करनी होगी।
एक AI मॉडल को एक पैराग्राफ भेजना आसान है।
उस मॉडल के चारों ओर एक विश्वसनीय बहुभाषी WordPress प्रणाली चलाना ही मुश्किल हिस्सा है।
REEID बहुभाषी WordPress को कैसे अप्रोच करता है
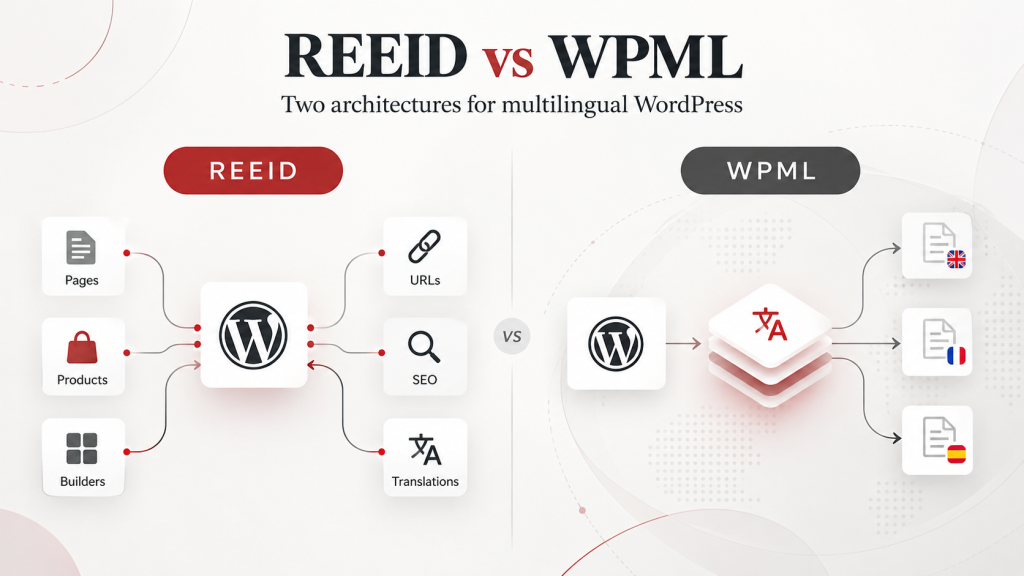
REEID बहुभाषी WordPress को एक तकनीकी सामग्री प्रोसेसिंग सिस्टम के रूप में अप्रोच करता है।
काम में टेक्स्ट को बदलने से ज्यादा चीजें शामिल हैं। इसमें यह समझना शामिल है कि WordPress सामग्री को कैसे संग्रहीत करता है, बिल्डर कैसे पृष्ठों को संरचित करते हैं, प्लगइन्स कैसे अतिरिक्त फ़ील्ड पेश करते हैं और भाषा संस्करणों को समय के साथ कैसे जोड़े रखना होता है।
यह अप्रोच इन चीजों को एक साथ लाता है:
- सामग्री की खोज
- संरचित निष्कर्षण
- WordPress नेटिव प्रोसेसिंग
- AI-सहायता वाला अनुवाद
- मेटाडेटा हैंडलिंग
- भाषा संबंध
- बहुभाषी SEO
- अनुवाद का पुनर्बल
- सिंक्रोनाइज़ेशन
- संगतता का काम
- चल रहा रखरखाव
उद्देश्य केवल अनुवादित टेक्स्ट बनाना नहीं है।
बल्कि बहुभाषी WordPress सामग्री बनाना है जो संपादनीय, जुड़ी हुई, खोजी जा सकती और रखरखाव के लिए उपयुक्त रहे।
निष्कर्ष
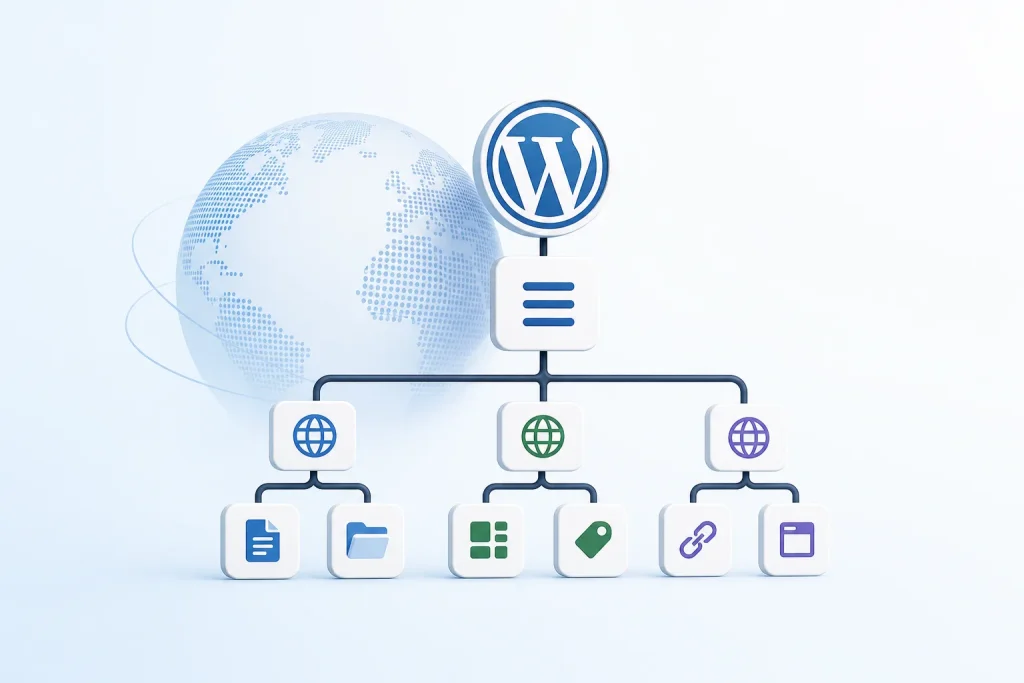
एक बहुभाषी WordPress वेबसाइट संबंधित सामग्री, संरचनाओं, URLs और तकनीकी संकेतों का एक नेटवर्क है।
अनुवाद उस नेटवर्क का एक महत्वपूर्ण हिस्सा है, लेकिन यह केवल एक हिस्सा है।
पूरी समस्या में सामग्री की खोज, बिल्डर संरचनाओं का संरक्षण, मेटाडेटा प्रोसेसिंग, URLs का प्रबंधन, भाषा संस्करणों को जोड़ना, SEO का समर्थन, परिणामों का कैशिंग, बदलावों का सिंक्रोनाइज़ेशन और समय के साथ संगतता का रखरखाव शामिल है।
बहुभाषी WordPress को अनुवाद के कार्य के रूप में लेना एक छोटे स्थैतिक पृष्ठ के लिए काम कर सकता है।
इसे एक इंजीनियरिंग सिस्टम के रूप में लेना ही इसे बड़े पैमाने पर विश्वसनीय रूप से काम करने की अनुमति देता है।
SOURCES & EVIDENCE
Google: स्थानीयकृत संस्करण · WordPress Metadata API · WordPress Rewrite API